模型里的森林,为什么总比真实森林年轻
一项桉树研究提醒我们:实验室最容易测量的幼苗,未必能代表更老的树,更不能自动代表一整片森林。
模型里的森林,为什么总比真实森林年轻
实验室里的树很听话。
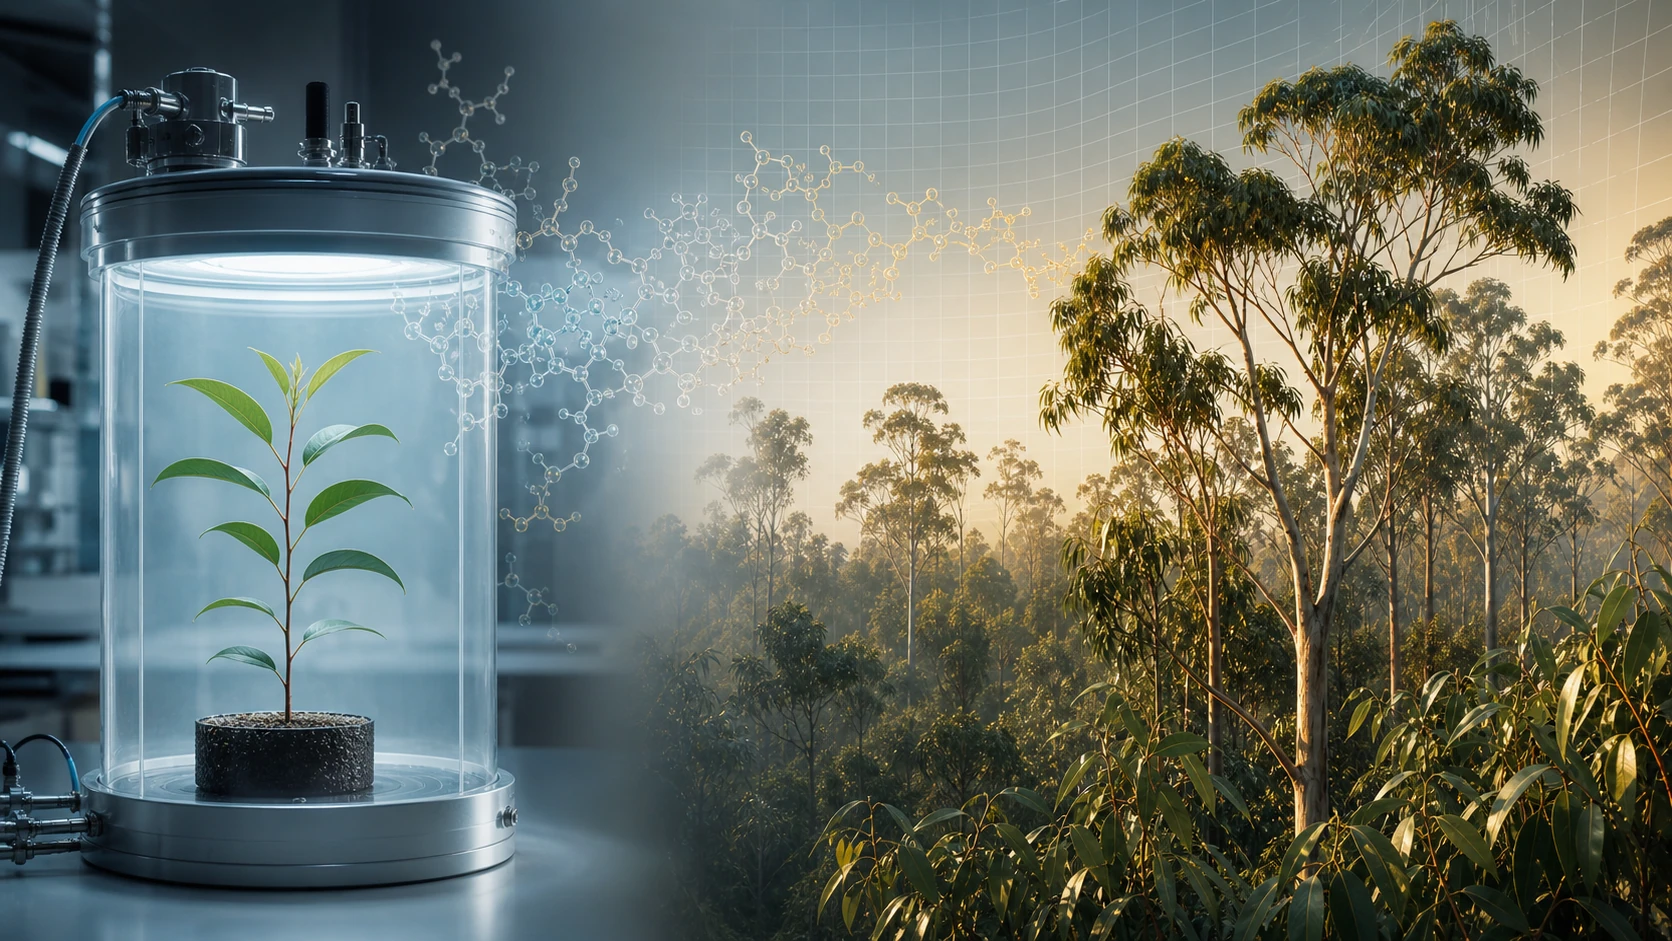
它被种在尺寸合适的盆里,枝叶不至于碰到仪器,整个植株可以进入测量舱。空气按设定的速度流过,光照和温度被记录下来,研究人员再从出口捕捉那些肉眼看不见的气体。真实森林则完全相反:树冠太高,枝条彼此遮挡,叶片年龄不同,根系伸进无法控制的土壤,风、热和水分每一分钟都在变化。
这就是植物挥发性有机物研究中一个不太显眼、却很根本的选择:为了把树搬进实验室,人们常常选择幼苗。幼苗容易获得、容易重复,也容易放进设备。但当这些测量结果被整理进排放数据库,再进入大气化学和气候模型时,一个问题会慢慢浮出来——模型里那棵“标准树”,到底几岁?
2026年发表于《Atmospheric Chemistry and Physics》的一项研究,把这个问题落在了桉树上。研究者比较了幼苗与两年生树的挥发性有机物排放。论文报告,两种年龄阶段不仅排放量不同,释放出来的分子组成也不同。这个结论听起来朴素:年轻的树和稍老的树不一样。真正值得注意的是,许多模型需要把植物写成参数,而参数常常没有“年龄”这一栏。
树释放的不是一种“气味”
植物挥发性有机物是一个很宽的集合。它们从叶片释放到空气中,参与植物与昆虫、病原体和邻近植株之间的关系,也会进入大气化学反应。不同分子的反应活性不同;它们对臭氧形成、二次有机气溶胶和区域空气化学的影响,也不能用一个总量完全概括。
因此,研究者测量的不只是“这棵树放出了多少气体”,还要问“放出了哪些分子”。如果总量相近而组成不同,进入大气后的化学命运仍可能不同;如果组成相似而总量变化,影响的尺度又是另一回事。把所有挥发物压成一根柱子,会像只统计一家餐馆每天端出多少公斤食物,却不记录那是米饭、辣椒还是油。
桉树尤其适合提醒人们注意这个问题。它以排放多种萜类化合物而闻名,也被广泛种植。但这项研究并没有证明“所有桉树都会怎样”,更没有证明“全球森林排放都被算错了”。它比较的是一个树种、两个年龄阶段和特定实验条件。严谨的写法不是把局部差异夸成全球结论,而是承认它揭示了一个数据库设计问题:年龄可能是此前被压缩掉的变量。
为什么大家爱测幼苗
答案并不神秘。科学不是在无限时间、无限预算和无限空间里进行的。
一棵成熟树不能被轻易塞进测量舱。即便研究者爬上树冠,只测一个枝条或几片叶子,也要面对叶龄、光照方向、冠层位置和当天气象条件的差异。幼苗则提供了可复制的对象:同一批种子、相近生长阶段、相似盆土和更容易控制的环境。对需要比较处理组的实验来说,这种标准化非常宝贵。
问题不在于测幼苗“错了”,而在于数据离开实验室之后,使用者是否还记得它来自幼苗。
一条测量记录进入数据库时,常会被归到物种、植被类型或功能类群之下。模型再把排放因子与叶面积、温度、光照等变量结合,估计一个地区在某一时段释放多少物质。经过几次汇总,原始样本的年龄、尺寸与生活史可能只剩在论文方法部分。最后出现在地图上的,是连续的颜色和整齐的数值,仿佛每一块森林都有同样清楚的答案。
模型必须简化现实,否则无法运行。真正的风险不是简化本身,而是简化的来源变得不可见。若数据库里某类树木的数据大多来自幼苗,模型的不确定性就不仅来自天气和空间分辨率,也来自“用谁代表谁”。
年龄不是一个可以随手补上的数字
直觉上,人们可能会说:既然发现幼苗和两年生树不同,那就在模型中加入年龄系数。事情没有这么快。
首先,两年生树也不是成熟森林。树木从幼苗到成年经历的变化未必是一条直线。叶片化学、防御策略、冠层结构、根系资源和繁殖状态都可能改变,排放也可能随季节、胁迫和组织位置变化。仅有两个年龄点,无法画出完整曲线。
其次,树龄和树的尺寸、环境经历往往缠在一起。更老的树通常更高、叶片分层更明显,经历过更多干旱、热浪和病虫压力。实验若发现年龄组差异,不能自动断言“年龄本身”是唯一原因。它可能代表一组随生长共同变化的特征。
再次,排放数据库服务的模型尺度不同。研究城市臭氧、区域气溶胶或全球碳—化学耦合,需要的物种细度、时间分辨率和误差容忍度并不一样。一个年龄变量是否值得加入,要看它能否在目标尺度上减少误差,也要看现实中是否有足够的森林年龄数据与之匹配。
所以,这项研究更像是一次压力测试,而不是一张修正表。它告诉模型团队:在增加新参数之前,先检查旧参数由什么样的树支撑;在声称提高精度之前,先问最基础的代表性是否成立。
一条数据的漫长旅程
从测量舱到空气质量地图,一条数据要经过许多人。
植物生理学家决定测哪种树、哪个生长阶段;分析化学家判断哪些分子能被仪器识别;数据库维护者决定如何归类和汇总;模型开发者选择参数化方式;最后,城市规划者、气候研究者或政策人员读到模型输出。每一棒都合理,但每一次交接也可能丢掉上下文。
这类误差很少像仪器故障那样显眼。仪器坏了,会出现异常峰值;代表性不足却可能给出非常平滑的地图。它不会报警,甚至显得比真实世界更整洁。
数据库治理因此不只是技术维护,也是一种记忆工程。好的数据库不仅保存一个推荐数值,还应保存它来自什么物种、什么年龄、什么组织、什么环境、怎样测得,以及在哪些条件下不该外推。对普通读者来说,这些元数据很枯燥;对模型来说,它们决定了数字有没有边界。
不要把另一篇论文的热浪写进来
这项研究还暴露出科技报道中一种常见诱惑:把相邻主题的漂亮数字拼到一起。
树木挥发物会受温度影响,近期也有研究讨论热浪如何改变某些化合物的排放配方。但“热浪效应”和“树龄效应”是两个不同问题。前者比较温度与极端条件,后者比较生长阶段。即使它们最终都会进入同一套大气模型,也不能把一篇论文里的倍数变化搬来解释另一篇论文。
在本次整理中,我们明确删除了此前被错误归到树龄论文的“近六倍增长”说法。纠正这件小事比保留一个抓眼数字更重要。因为文章真正讨论的,恰恰是数据离开原始语境之后怎样变得过度自信。如果一篇文章自己也把数字搬错了地方,它就重复了它想批评的问题。
谁需要为“标准树”负责
研究结果最直接影响的,不是每天走过街边桉树的人,而是那些维护排放因子、建立植被清单和解释模型差异的人。对他们来说,下一步未必是立刻重写全部模型,而可能是更朴素的工作:标注数据来源的年龄分布,检查关键物种是否过度依赖幼苗,寻找树冠和不同生长阶段的补充测量,并在输出中把这部分不确定性说清楚。
这也会改变科研资源的价值排序。测一批整齐幼苗,往往比长期追踪不同年龄的树更快、更容易发表;后者却可能更接近数据库真正缺少的信息。谁愿意为这些慢、杂、难标准化的数据付费,决定了模型里的森林会不会一直停留在苗圃。
对政策使用者而言,最需要警惕的不是模型“有误差”——所有模型都有误差——而是误差被一个漂亮的空间分辨率掩盖。地图可以细到街区,不代表支撑它的生物参数也细到树龄。像素变小,不会自动让样本更有代表性。
这里还有一个容易被忽略的公平问题。拥有长期样地、冠层设备和连续化学测量能力的地区,更有机会把本地树种写进模型;缺少这些基础设施的地区,只能借用别处、别种甚至别龄的数据。地图表面覆盖全球,证据密度却可能极不均匀。模型维护者若公开样本来源和空白区域,就能让使用者知道哪些地方是测出来的,哪些地方主要靠推断。承认地图上存在“证据稀薄区”,不是削弱科学权威,而是避免精细颜色制造虚假的同等确定性。
回到那棵装得进仪器的树
实验室里的幼苗没有做错任何事。它只是太方便了:高度合适,叶片完整,能在一天里完成测量。真正的问题发生在它被逐步抽象成“桉树”,再被抽象成“森林”的时候。
科学需要替身。细胞替代器官,模型动物替代人,幼苗替代森林。替身让不可测量之物变得可研究,也总会带来距离。成熟的科学并不是假装这段距离不存在,而是给它命名、测量它,并在数据被带往更大尺度时把它一起带走。
下一次看到一张颜色精细的植物排放地图,也许值得多问一句:图里的树从哪里来?如果答案是一间实验室、一只透明测量舱和一棵还没有长高的幼苗,那么地图并非因此失效。它只是需要把年龄写回自己的图例。
来源与边界
- 核心一手来源:Atmospheric Chemistry and Physics 论文,https://acp.copernicus.org/articles/26/6213/2026/
- 模型背景来源:MEGAN 2.1 基础论文,https://doi.org/10.5194/gmd-5-1471-2012
- 本文只说明一个桉树物种、幼苗与两年生树之间的差异及其数据库意义,不外推全球森林,不把观察差异写成单一年龄因果。
- 本文不沿用其他热浪研究的倍数数字,也不提供任何植物培养或实验操作流程。