基因效应为什么会被显著性门槛挡住
一项对928人、7类免疫细胞的研究不再只数显著eQTL,而是估计共享与细胞型特异遗传方差;它揭示的不是一张致病清单,而是一把长期偏爱大而普遍效应的统计尺子。
基因效应为什么会被显著性门槛挡住
想象一张研究结果表。每一行是一个基因,每一列是一类免疫细胞。研究者把遗传变异与基因表达的关系逐格检验,最后只保留越过显著性门槛的格子。表格一下变得整洁:这里有信号,那里没有;这个效应属于单核细胞,那个效应似乎在各种细胞中都存在。
但整洁可能是一种错觉。一个格子空白,至少有两种解释:那里真的没有效应;或者效应存在,只是样本量、细胞数量和测量噪声不足以让它越过门槛。若第二种情况在不同细胞类型中发生的概率不一样,“显著结果清单”就不再是一幅中性的生物学地图。它也画进了仪器与统计功效的阴影。
2026年8月26日发表于《自然》的一项研究,试图绕开这道门。Minhui Chen、Andy Dahl等研究者提出CIGMA——细胞类型信息遗传混合模型分析。它不以找到多少个显著单一位点为首要目标,而是问一个更整体的问题:围绕某个基因的一组遗传变异,究竟有多少表达差异可由所有细胞共享的效应解释,又有多少只能由特定细胞类型中的效应解释?
团队把模型用于OneK1K队列中928名参与者的外周血单个核细胞,覆盖7种最常见的免疫细胞类型和10,288个基因。结果显示,细胞型特异的eQTL并非边角料;在这套数据与模型中,它们与复杂性状遗传度的富集联系,反而比细胞型共享效应更醒目。
这不是“找到疾病基因”的新闻。更准确地说,它是对发现机制本身的一次审问:我们长期称为“已知eQTL”的对象,究竟有多少是生物学上最重要的,又有多少只是最容易被现有尺子看见的?
eQTL不是基因开关清单
eQTL是“表达数量性状位点”的缩写。它描述的是一种统计关联:某个遗传变异与某个基因的RNA表达量差异相关。它不是一颗写着“患病”或“健康”的按钮,也不等于已证明该变异通过这个基因导致某种疾病。
细胞类型让事情更复杂。同一套DNA存在于一个人的多类细胞中,但不同细胞启用的调控程序不同。一个变异对基因表达的影响,可能在B细胞里清楚,在T细胞里微弱,在单核细胞里又呈另一种强度。把各种细胞混在组织样本里测平均表达,少数细胞中的效应可能被稀释;即便先把细胞分类,逐类寻找“显著位点”,低丰度、噪声较大或效应较弱的格子仍更难过线。
过去的单细胞研究已经证明细胞分辨率有价值。2018年,一个独立团队分析45名供者约25,000个外周血单个核细胞,发现了此前未见的细胞型特异cis-eQTL。这里的cis大致指位于被调控基因附近的效应。2022年的OneK1K研究进一步在更大规模的血液单细胞数据中绘制14类免疫细胞的eQTL,并把部分信号与自身免疫性疾病的GWAS位点联系起来。
然而,能发现更多显著信号,不等于已经知道所有效应如何分布。传统映射仍会先问某一个变异是否显著,再对过线者谈“共享”或“特异”。这好比只让通过海选的人参加人口普查:名单当然真实,却未必代表整个人群。
CIGMA换了一种提问方式
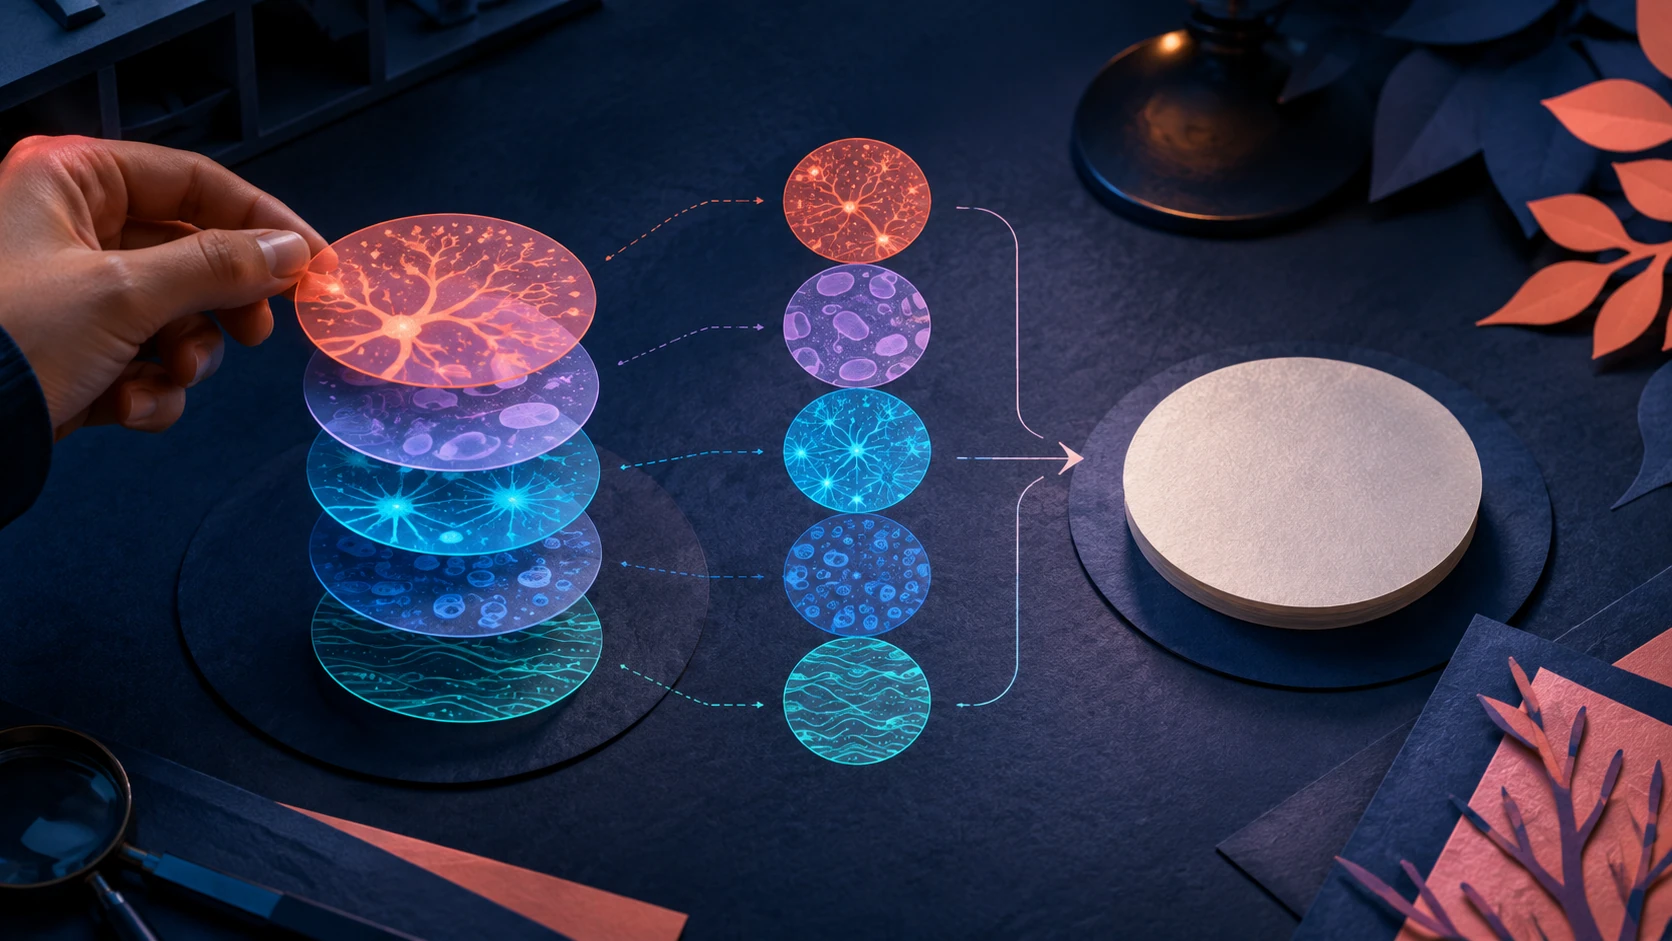
CIGMA把每名参与者在预先定义细胞类型中的单细胞表达先汇总成pseudobulk,也就是“按人、按细胞类型取一个汇总表达值”。随后,它用混合模型把遗传效应拆成两部分:一部分在不同细胞类型间共享;另一部分允许各细胞类型拥有额外效应。模型还显式考虑同一人同类细胞内部的波动和实验噪声。
关键变化在于,CIGMA不要求每一个变异先单独拿到“显著入场券”。它估计一组变异合起来解释多少表达方差,再计算其中多少属于细胞型特异成分。这让研究者可以讨论整套遗传效应的分布,而不是只从最亮的几个点推断黑暗里还有什么。
在928人的主分析中,团队仍进行了逐基因显著性检验:193个基因通过了严格的Bonferroni校正阈值。其中97个并没有同时出现显著的细胞型特异残余个体差异,支持模型并非只是把所有人与人之间的变化都误贴成遗传效应。不过,作者特意把193称为保守下限,因为“是否显著”依然受功效支配。真正更值得注意的是跨基因汇总的方差结果。
在全转录组口径下,cis eQTL大多在细胞间共享,估计的特异比例为31.1%,标准误1.3%;跨染色体定义的trans效应则大多具有细胞型特异性,比例为59.4%,标准误4.6%。这两个百分比描述的是模型估计的方差比例,不是说“31.1%的cis位点”或“59.4%的trans位点”已被逐个验证只在某类细胞起作用。
距离也改变了画面。当cis窗口从基因附近5千碱基扩大到100万碱基,模型估计的细胞型特异性从30%升到41%。它与一种已知倾向相符:传统eQTL更容易在转录起始位点附近看到较大的调控效应,而更远的增强子作用常更依赖细胞环境。但这个趋势不能把每个远端变异自动认证为功能元件。
“显著”筛掉的,可能恰是重要部分
2023年,斯坦福大学的Hannah Mostafavi、Jonathan Pritchard等人在《自然·遗传学》发表了一项独立研究。他们比较118,996个已知eQTL与22,119个GWAS命中,发现两类研究的发现机制偏爱不同的变异。
eQTL研究容易检出对表达影响较大的变异;GWAS则检出对性状乘积效应足够大的变异。一个变异即便确实通过表达影响性状,如果它对表达的直接效应较小,仍可能过不了典型eQTL研究的阈值。该研究进一步提出,自然选择会让涉及重要、受约束基因的大效应调控变异较难以常见频率留在人群中。因此,最容易被eQTL研究发现的,可能系统性偏向启动子附近、效应较大、选择约束较弱的那一部分。
这是CIGMA论文最重要的背景,也是需要分清的证据关系:Mostafavi团队没有复现CIGMA;他们研究的也不是同一问题。前者说明“显著eQTL清单为何可能不是中性样本”,后者则在细胞类型层面尝试估计被清单漏掉的整体方差。两者相接,才构成一条较完整的解释:平均值遮住细胞环境,阈值又从留下的信号中偏爱大而普遍者。
CIGMA团队还发现,细胞型特异性较高的基因,往往具有更强的进化约束、更复杂的增强子结构和更多基因网络连接。这些特征恰是传统已知eQTL相对缺少、却在复杂性状相关基因中较常见的。研究者随后用连锁不平衡评分回归,考察排名前200的细胞型特异eGenes是否落在复杂性状遗传度较集中的区域。在10个性状中,它们对7个血液相关性状中的4个显示富集,而对3个较少与血液相关的性状均未检出富集。共享效应排名前200的基因和模拟整体血液的基因集合没有出现同样结果。
这个结果与样本来自血液相称,也提醒我们不能把它扩展成“细胞型特异eQTL普遍解释所有复杂疾病”。富集是基因集合层面的统计关系;它不证明某个变异导致疾病,也不为任何人提供风险判断。
第二套数据不是第二个团队
论文还使用CLUES单细胞数据检验结果在另一队列和不同祖源群体中的一致性。这增强了稳健性,但措辞必须克制:CLUES分析由同一篇论文的作者完成,使用同一套方法与研究判断,属于跨数据集重复和敏感性证据,不是外部团队的独立复现。
更重要的是,跨祖源一致并不等于祖源代表性问题已经解决。两个数据集在样本构成、细胞数量和遗传结构上不同;CLUES还包含系统性红斑狼疮病例与对照,而论文没有分析病例与对照之间的eQTL特异性差异。作者能说的是,共享与特异方差的总体方向在这些数据中相容;不能说这套比例已经是全人类的常数。
新尺子也有自己的盲区
CIGMA用pseudobulk降低了单细胞测量的复杂度,同时也把同一标签内部的细胞状态压成平均值。处在激活、分化或环境刺激中的细胞,可能拥有连续变化的调控效应;预先切成7类,仍会漏掉类内差异。作者认为这种汇总更可能低估遗传方差与特异性,而非夸大它们,但这仍是一项模型判断。
模型估计的是变异集合的方差,因此不能直接完成GWAS与具体eQTL的共定位,也不能回答某个单一位点通过哪个细胞、哪个基因影响性状。它的估计更噪,没有处理所有非高斯数据特征,也未完整建模细胞之间复杂的谱系与相似关系。广义细胞协方差在当前样本量下同样不够精确。
还有一个容易被“百分比”遮住的概念问题:细胞型特异性依赖表达值采用什么尺度。原始计数、归一化值或变换后的表达量,可能改变加法效应看起来多“特异”。作者在两种尺度、多种质量阈值、协变量设置和遗传主成分数量下得到相近方向,这是有价值的稳健性检查,却不是数学意义上的尺度免疫。
利益冲突方面,论文作者声明没有竞争利益。该声明值得记录,但不能替代对方法、数据和结论的审查。研究使用既有参与者数据和公开遗传资源;对普通读者更现实的伦理边界,是不要把群体统计重新包装成个人标签。eQTL方差无法告诉某个人会不会患病,也不该成为对单个患者的解释。
谁被一张干净表格遮住
科学必须设阈值。面对上万基因、数百万变异和多类细胞,如果没有多重检验控制,假阳性会淹没结论。问题不在于显著性门槛本身,而在于我们是否把“没有过线”误读成“那里没有生物学”。
CIGMA的贡献,是把这两个命题重新分开。它没有让弱信号自动变真,也没有给所有空白格补上故事。它只是提供另一种总量估计,让研究者看到:那些未能作为单个位点登上名单、又随细胞环境变化的效应,可能在复杂性状的遗传结构中占有系统性位置。
这改变的首先是研究资源如何分配。若实验室只围绕最大、最稳定、最容易重复显著的eQTL追机制,就可能不断照亮同一批启动子附近的强效应,而把稀有细胞、连续状态、远端调控和受选择约束的基因留在暗处。新的模型不替代后续的单变异定位、功能实验或疾病组织研究;它更像一张欠账单,提醒研究者哪些区域可能因为尺子的偏好而长期缺少投入。
回到开头那张表。空白仍然是空白,我们不能凭想象把它涂满。但现在,研究者至少知道其中有些空白不是生命保持沉默,而是统计系统暂时没有听清。真正谨慎的科学,不只是尊重亮起来的格子,也要记得:可见性从来不是重要性的同义词。
来源与边界
核心研究来自Chen等人2026年发表于《自然》的CIGMA论文;样本、模型、数值、局限和“无竞争利益”声明均按论文正文、Methods与Ethics declarations核查。显著性筛选偏差的独立背景来自Mostafavi等人2023年的《自然·遗传学》论文;早期单细胞eQTL证据来自van der Wijst等人2018年的独立研究。OneK1K的2022年Science论文是本研究主数据来源的背景,不算外部复现;同文CLUES分析也不称独立团队复现。
本文讨论的是统计遗传学证据,不提供湿实验步骤、遗传序列、个体风险解释、诊断或治疗建议。CIGMA没有证明单个变异、基因或细胞类型导致某种疾病,也不能替代GWAS共定位、功能验证、病例—对照研究和更广泛人群中的外部复现。